A XPENG, em conjunto com investigadores da Universidade de Pequim, da Universidade de Hong Kong e outras instituições académicas, apresentou o GroundingPI, um modelo de perceção visual de código aberto para aplicações de Physical AI, ou seja, inteligência artificial aplicada ao mundo físico.
O modelo conta com cerca de 4 mil milhões de parâmetros e foi concebido para identificar objectos com precisão e compreender a sua localização espacial em ambientes reais, uma capacidade essencial tanto para a robótica como para a condução autónoma.
Nas avaliações conduzidas pela equipa de investigação, o GroundingPI foi comparado com 44 modelos de referência em 34 benchmarks de perceção distribuídos por 11 categorias de capacidades. Com uma ponderação igual para todas as categorias, o modelo alcançou uma pontuação global de 73,68 pontos, superando os 71,54 pontos registados pelo GPT-6 Astra. É importante sublinhar que esta comparação diz respeito exclusivamente a tarefas de perceção visual e não representa uma avaliação abrangente das capacidades de raciocínio geral dos sistemas em causa.
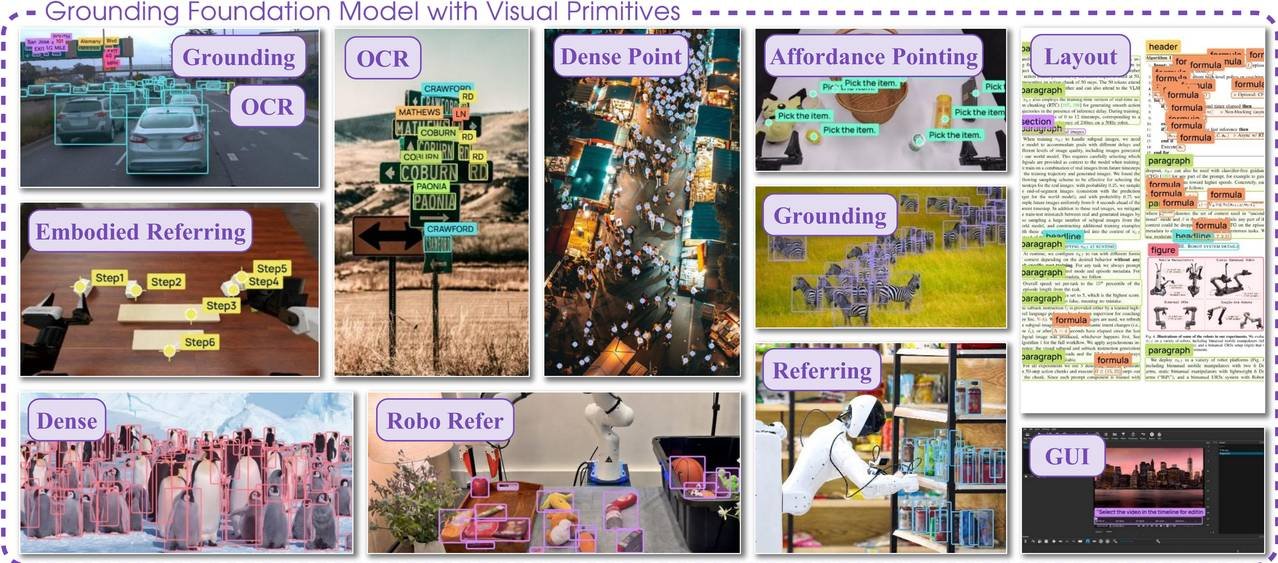
A abordagem seguida pelos investigadores distingue-se por se concentrar nas capacidades fundamentais de compreensão visual antes de integrar qualquer lógica de acção robótica. Em vez de treinar o modelo com etiquetas de acções, a equipa focou-se em desenvolver uma base sólida de perceção que possa depois ser aproveitada por sistemas de aprendizagem de acções numa fase posterior. Para ilustrar o tipo de raciocínio exigido, basta pensar numa instrução como “identificar a pega da chávena que está à direita”: o sistema tem de localizar não só a chávena correcta, mas também a posição exacta da respectiva pega, representando essa informação através de coordenadas espaciais e caixas delimitadoras.
Os resultados em simulação apontam para duas vantagens práticas relevantes. A primeira tem a ver com a eficiência na utilização de dados de treino: nas experiências de simulação RoboCasa-GR1, os sistemas robóticos que usaram o GroundingPI como base visual conseguiram taxas de sucesso superiores recorrendo a apenas 50% dos dados de demonstração disponíveis, quando os modelos de referência precisaram de 75% desses mesmos dados para obter resultados equivalentes. A segunda vantagem prende-se com a capacidade de adaptação: nas avaliações de simulação RoboTwin 2.0, o GroundingPI mostrou um desempenho superior em quatro cenários com distribuição de dados diferente daquela usada no treino, o que sugere uma maior resiliência perante ambientes desconhecidos. No domínio da condução autónoma, quando integrado como base visual no conjunto de dados nuScenes, o modelo alcançou um erro médio de previsão de trajectória em circuito aberto de 0,296 metros.
O modelo foi treinado em 11 categorias de capacidades de perceção, entre as quais a detecção de objectos, a localização detalhada de elementos visuais com base em descrições textuais, o reconhecimento óptico de caracteres, a compreensão da estrutura de documentos, o reconhecimento de elementos de interfaces de utilizador e a localização espacial aplicada à robótica. Estas conclusões apontam para que o pré-treino orientado para a perceção possa constituir uma base valiosa para a investigação futura em Physical AI, complementando as capacidades mais abrangentes de raciocínio e planeamento dos modelos generalistas.
Com o objectivo de fomentar a colaboração científica, a equipa disponibilizou publicamente o artigo científico, os pesos do modelo e o respectivo código de suporte. Os recursos estão acessíveis no website do projecto em groundingpi.github.io, no repositório GitHub em github.com/groundingpi/GroundingPI e na plataforma Hugging Face. Vale a pena notar que a investigação se encontra ainda numa fase exploratória e que os resultados obtidos em simulação não significam que a tecnologia esteja pronta para implementação comercial em condições reais, nem constituem um anúncio de integração nos produtos da XPENG.